Bomb lab
本篇讲述 Bomb lab 解题思路过程,涉及剧透可以先思考后再来看
目录
解压后你将得到以下文件
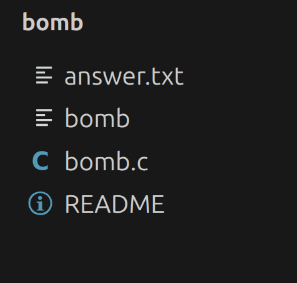
answer.txt 是帖主手动加的便于直接跳过已经解决的题目(用处后文会讲)
其中我们只需要看 bomb.c 文件以及运行 bomb 即可
点开 bomb.c 后我们能看到 bomb 的源码至于英文内容帖主做了个机翻各位可以参考下
机翻内容
开头剧情的翻译
邪恶博士的阴险炸弹,版本 1.1

Dr. Evil 公司允许你使用这个炸弹,但这个许可会在“受害者死亡”时失效。
公司不对挫败、疯狂、失眠、鼠标手等后果负责,除非这些事情是公司故意造成的。
受害者不能把炸弹源码交给敌人,也不能通过调试、反汇编、运行 strings、反汇编、解密等方式了解炸弹并拆除它。
处理炸弹时不允许穿防爆服。
Dr. Evil 不会为自己糟糕的幽默感道歉。
代码中的注释翻译
/* Note to self: Remember to erase this file so my victims will have no
 * idea what is going on, and so they will all blow up in a
 * spectaculary fiendish explosion. -- Dr. Evil */
提醒自己:记得删掉这个文件,不要让受害者知道发生了什么,这样他们就都会在一场邪恶而壮观的爆炸中被炸飞。
/* When run with no arguments, the bomb reads its input lines
 * from standard input. */
如果运行炸弹时不带参数,它会从标准输入读取每一行输入。
/* When run with one argument <file>, the bomb reads from <file>
 * until EOF, and then switches to standard input. Thus, as you
 * defuse each phase, you can add its defusing string to <file> and
 * avoid having to retype it. */
如果运行炸弹时带一个文件参数,它会先从这个文件读取输入,直到文件结束,然后再切换到标准输入。
因此,你每破解一关,就可以把这一关的答案添加到文件里,这样以后就不用重复输入之前的答案了。
/* You can't call the bomb with more than 1 command line argument. */
运行炸弹时最多只能提供一个命令行参数。
/* Do all sorts of secret stuff that makes the bomb harder to defuse. */
做一些秘密操作,让炸弹更难拆除。
/* Hmm... Six phases must be more secure than one phase! */
嗯……六个阶段肯定比一个阶段更安全!
input = read_line();       /* Get input */
phase_1(input);            /* Run the phase */
phase_defused();           /* Drat! They figured it out!
                            * Let me know how they did it. */
input = read_line(); /* 获取一行输入 /
phase_1(input); / 执行第一关 /
phase_defused(); / 糟糕!他们居然破解了!
* 让我知道他们是怎么做到的。 */
/* The second phase is harder. No one will ever figure out
 * how to defuse this... */
第二关更难。绝对不会有人知道怎么拆除它……
/* I guess this is too easy so far. Some more complex code will
 * confuse people. */
我觉得目前为止太简单了。加一些复杂代码,应该就能把人搞糊涂。
/* Oh yeah? Well, how good is your math? Try on this saucy problem! */
是吗?那你的数学水平怎么样?来试试这道调皮的问题!
/* Round and 'round in memory we go, where we stop, the bomb blows! */
我们在内存里绕啊绕,停在哪里,炸弹就在哪里爆炸!
/* This phase will never be used, since no one will get past the
 * earlier ones. But just in case, make this one extra hard. */
这一关本来永远不会被用到,因为没人能通过前面的关卡。不过为了以防万一,还是把它设计得特别难。
/* Wow, they got it! But isn't something... missing? Perhaps
 * something they overlooked? Mua ha ha ha ha! */
哇,他们居然成功了!但好像还有什么东西……不见了?也许他们忽略了什么?哈哈哈哈! 这可能说明除了 6 个阶段其实还有个
隐藏阶段
解题思路
由上面翻译可知我们需要解决 6(7) 个阶段的炸弹才能摆脱邪恶博士的威胁而真正的 key 则是藏在已经汇编好的程序当中
可当我们运行程序
./bomb
输入一个随机字符串后炸弹就爆炸了?我们该怎么获取 key 呢?
其实博士的注释就提示我们了
受害者不能把炸弹源码交给敌人,也不能通过
调试、反汇编、运行 strings、反编译、解密等方式了解炸弹并拆除它。
也就是说我们可能需要设置断点,调试,反汇编来获取 key 这便是我们的解题策略
gdb 使用
接下来的反汇编需要用到 gdb
关于 gdb 的安装以及使用可以参考该文 点我
6 个 phase 解题思路
进入 gdb 我们开始对程序反汇编(拆雷)
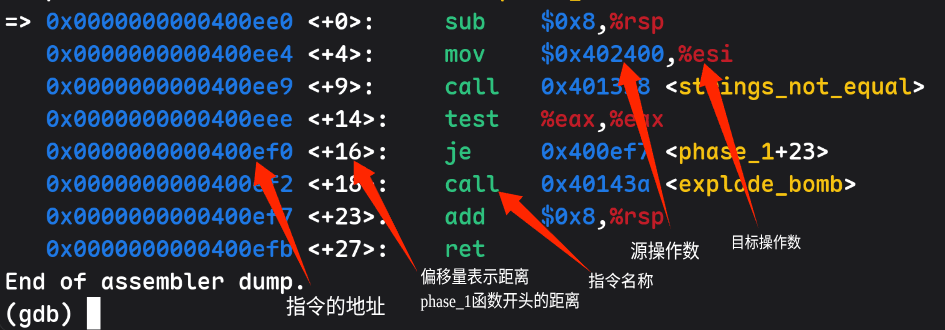
反汇编识别可得到如下内容
基本的指令有如下
sub    减法
mov    移动/赋值(注意:通常调用 move 时会对寄存器的值解引计算,别的指令一般都是地址计算)
call   调用函数
test   测试
je     条件跳转(jump if equal)等于
jne    条件跳转(jump if not equal)不等于
jg     条件跳转(jump if greater)大于-有符号
ja     条件跳转(jump if above)大于-无符号 # 四个跳转都是看上一个指令的标志位
add    加法
ret    函数返回
push   将寄存器保存在栈上
pop    将寄存器恢复
cmp    比较指令
  b: 8 位 cmpb
  w:16 位 cmpw
  l:32 位 cmpl
  q:64 位 cmpq
lea    加载有效地址(Load Effective Address),参与地址计算
在 Linux x86-64 的函数调用约定中,经常会用到以下寄存器:
%rax:函数返回值
%rbx: 通用寄存器,但函数需要记录其原值
%rdi:第一个函数参数(通用寄存器,不需记录原值,下同理)
%rsi:第二个函数参数
%rdx: 第三个函数参数
%rcx: 第四个函数参数
%rbp: 栈帧指针(存储返回地址及寄存器状态等信息)或普通寄存器
%rsp:栈顶指针
%rip: 指令指针(保留当前执行指令的地址)
%rflags: 保存 CPU 状态标志
  ZF:Zero Flag 结果是否为 0
  SF:Sign Flag 结果是否为负数
  CF:Carry Flag 是否产生进位
  OF:Overflow Flag 是否溢出
这里的反汇编其实就像把以前写的每一行指令拆成了细致的每一步,而每一步你都可以清晰的溯源查看,很多步骤设计计算机底层,而这个 lab 的设计目的也就在此
拆炸弹的大致的思路是:
- 设置当前 phase 的断点
- 运行程序到断点处
- 查看汇编,找到 key 藏匿点
- 输入 key 到下一关
考虑到直接给答案不利于各位学习我这里做了折叠处理
想不明白可以看下我的思路
phase_1
phase_1 点开查看
我们进入 gdb
gdb ./bomb
随后设定断点,运行
break phase_1
run
进入程序后随便输入一串字符程序会因进入断点而停止
此时对该程序进行反汇编
disassemble phase_1
可以看到如下内容
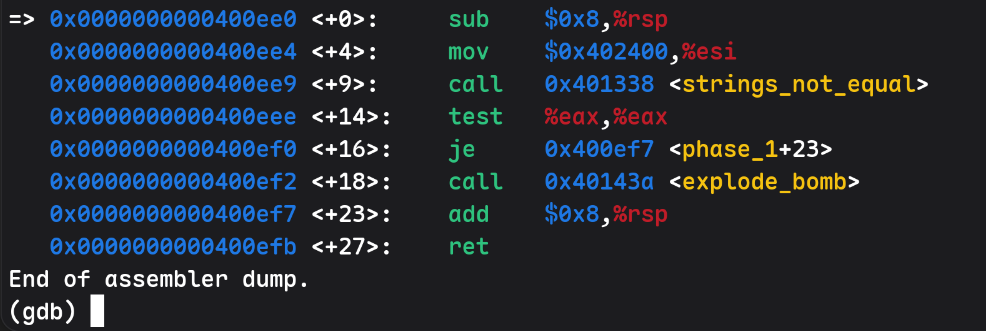
其中我们按顺序可以看到
1.系统先申请了 8 个字节的空间用于函数调用
2.系统将 0x402400 地址处的内容(变量)移到了 %esi 缓存器当中 #这意味着这个变量被调用了可能就是我们要的 string 密钥
3.系统调用了函数(strings_not_equal) # 我们估计这个就是决定是否爆炸的函数
4.系统调用了 test 测试,而这个测试需要两个输入值 #自然就是我们的输入值以及 key
5.条件判断 je(jump if equal)  即:当上面的 test 判断两个变量相等时跳转到地址 0x400ef7 # 刚好跳过下面 explode_bomb 函数
6.炸弹爆炸
7.释放函数占用的空间
8.程序结束
由上面的程序运行我们可以知道 0x402400 应该就是我们要的 key 的地址位置
于是我们马上对其进行汇编
x/s 0x402400
便可得到一串神秘字符串
0x402400: "Border relations with Canada have never been better."
那么恭喜你你找到了第一个炸弹的 key (
当然还有 2 3 4 5 6 关)
phase_1 完成后你可以把 1 阶段的答案放进 answer.txt 内这样下次只需要用参数形式用该文件启动 bomb 就可以直接到第二阶段啦
在 gdb 里像这样运行即可
break phase_2
run answer.txt
非 gdb 直接放在后面就行
./bomb answer.txt
注意: 该 lab 的 getline() 函数较为严格 .txt 文件内每行一定要换行,即使你只有一行也要按下 enter 换行,保证每行有换行符
下面的几个阶段同理
phase_2
phase_2 点击打开
还是按照 phase_1 的打开流程你会得到如下的信息
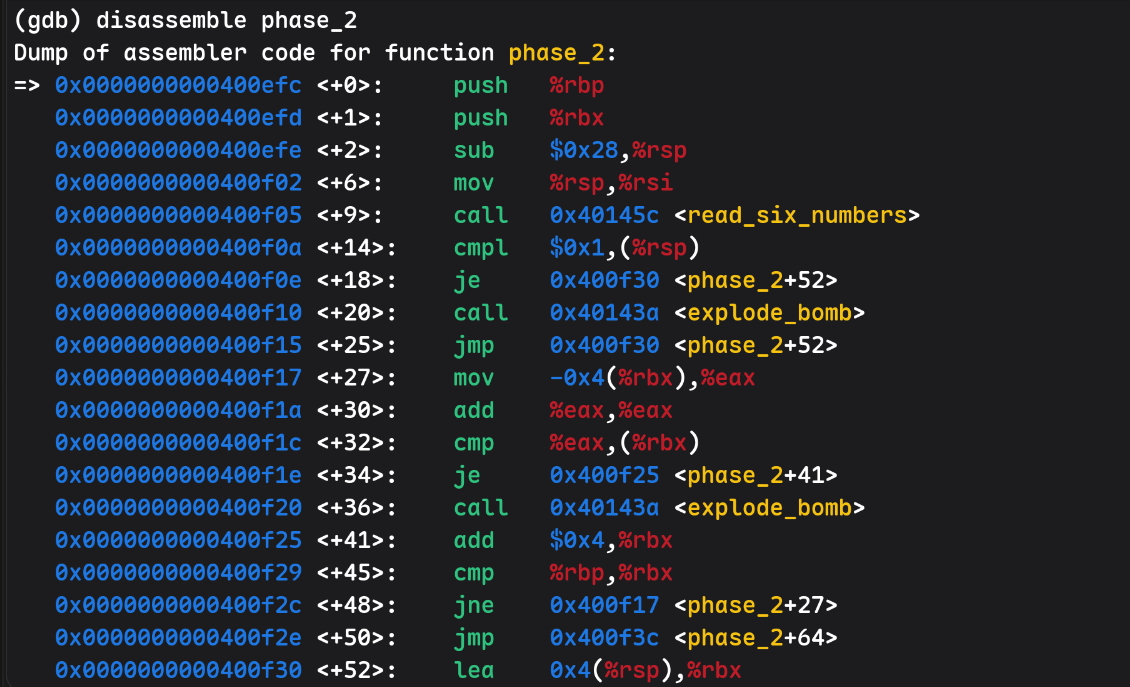
但此时请你注意你会发现最后一个指令为 lea 并没有释放空间即 add 或者函数的结束指令,可见 phase_2 指令并没有展示完全所以接下来我们输入
x/8i 0x400f30
得到剩余指令
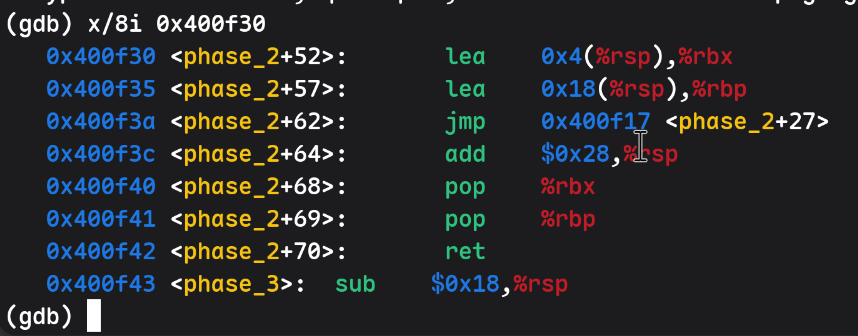
烧脑的来哩!!这一整个 phase_2 函数可能需要你花段时间来理解,我们慢慢来讲
1. 系统先 push 两个寄存器 %rbp %rbx 入栈
2. 系统借 40 个 byte 空间, %rsp 为当前栈顶的指针
3. 将 %rsp 放进 %rsi 作为(read_six_numbers)第二个参数
4. 调用(read_six_numbers)在栈中存 6 个 4byte 数字
5. 判断 *(%rsp) == 1
6. 判断生效跳转到 0x400f30
7. 地址计算 %rbx = %rsp + 4
8. 地址计算 %rbp = %rsp + 24
9. 跳转到 0x400f17
10. /*
12. %eax = *(%rbx - 4)
13. %eax += %eax
14. 判断 *(%rbx) == %eax
15. 判断生效跳转到 0x400f25
16. %rbx += 4
17. 判断 %rbx != %rbp
18. 判断生效跳转到 0x400f17
19. */ 这一段开始循环 5 次
20. %eax = *(%rbx - 4)
21. %eax += %eax
22. 判断 *(%rbx) == %eax
23. 判断生效跳转到 0x400f25
24. %rbx += 4
25. 判断 %rbx != %rbp
26. 判断未生效跳转到 0x400f3c
27. 释放函数空间
28. 弹出 %rbx %rbp
29. 程序结束
由此我们可以得出 1-6 这 6 个神秘小数字似乎在循环时有自己的规律即
‘1’ = 1
‘2’ = ‘1’ * 2
‘3’ = ‘2’ * 2
…
‘6’ = ‘5’ * 2
那么显而易见我们的 phase_2 密码就是 1 2 4 8 16 32 咯!恭喜
从这开始你就发现开始上难度了,可能不光是线性的理解,他会有循环的理解
phase_3
phase_3 点开查看
三阶段同上直接开始分析
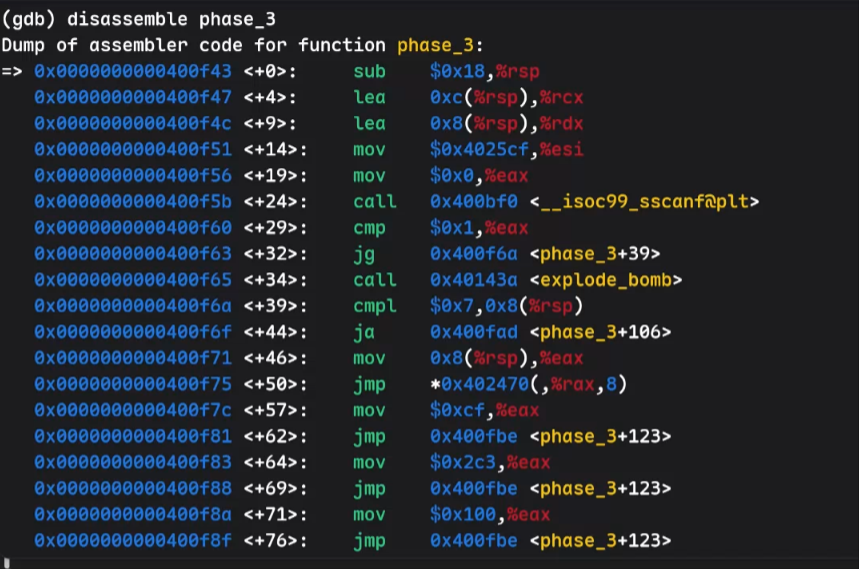
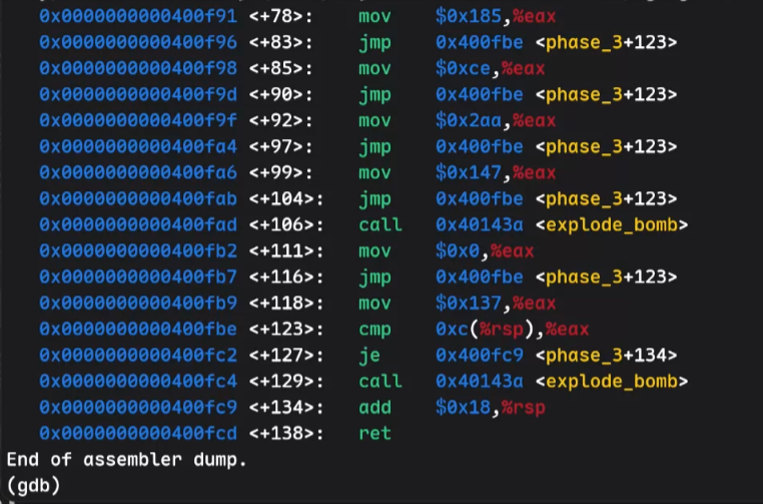
1. 借用 24 字节空间
2. rcx = rsp + 12, rdx = rsp + 8
3. esi = *($0x4025cf)
4. eax = *($0x0)
5. 调函数(__isoc99_sscanf@plt)
这里我们可以试图理解下 sscanf 函数
还记得在 C 里面的 sscanf 吗?
sscanf(input, “%d %d”, &a, &b);
上面 2-4 其实就是准备这 4 个参数而用的
其中 esi 用于存放读取格式 x/s 转换后你能得到 “%d %d” 也就是案例中的第二个参数
而 &a = rsp + 8, &b = rsp + 12
我们继续分析
6.判断 eax > 1
7.成立跳转 0x400f6a
8.判断 *(8 + rsp) > 7 # (8 + rsp) 则为我们刚刚 &a 的地址
9.未成立
10.eax = *(rsp + 8)
11.跳转到 *(0x402470 + 8rax)
此处注意 rax 为 eax(32位) 的 64 位扩展
因而在 eax 赋值时 rax 会自动补 32 个前导 0 补成为 64 位,此处 eax 赋值肯定没超过 32 位阈值,所以 rax == eax
但是我们现在有个问题 rax 值到底是什么?
想要继续推演下面的跳转位置我们需要知道 rax 才能去对应地址(0x402470 + 8rax)解引得到跳转地址
我们不妨向前定位,你便可找到 eax = *(rsp + 8)
而 *(rsp + 8) > 7未生效,也就是说 rax = eax <= 7,用户输入的 a 可能有 8 种结果即 a = 0-7
那么….
你想到什么了?
根据输入值指定跳转一跳还有 8 个….
没错!是 switch 语句,以及对应的 8 个 case
那么我们不妨来挖挖这 8 个 case 到底跳转地址是什么吧
我们不妨输入这种查看方式
x/8ga # 表示以 8 个字节(giant word 也就是 g) 按照 address 形式显示
随后我们可以得到下地址
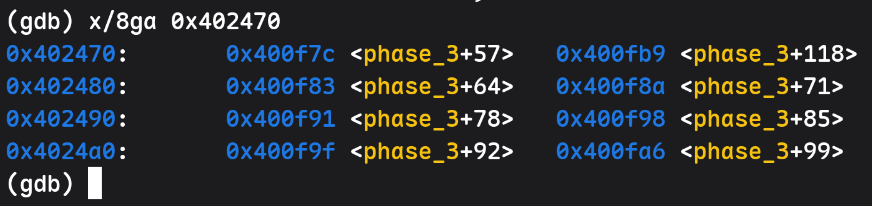
case1: 0x400f7c
case2: 0x400fb9
case3: 0x400f83
case4: 0x400f8a
case5: 0x400f91
case6: 0x400f98
case7: 0x400f9f
case8: 0x400fa6
接下来我们分 8 个 case 分开来分析
由于 case 太多帖主进行了折叠处理方便各位看
case1 点击打开
1. eax = 207
2. 跳转 0x400fbe
3. 判断 eax == *(rsp + 12)
4. 成立跳转 0x400fc9
5. 恢复空间
6. 程序结束
case2 点击打开
1. eax = 311
2. 跳转 0x400fbe
3. 判断 eax == *(rsp + 12)
4. 跳转 0x400fc9
5. 恢复空间
6. 程序结束
case3 点击打开
1. eax = 707
2. 跳转 0x400fbe
3. 判断 eax == *(rep + 12)
4. 成立跳转 0x400fc9
5. 恢复空间
6. 程序结束
case4 点击打开
1. eax = 256
2. 跳转 0x400fbe
3. 判断 eax == *(rep + 12)
4. 成立跳转 0x400fc9
5. 恢复空间
6. 程序结束
case5 点击打开
1. eax = 389
2. 跳转 0x400fbe
3. 判断 eax == *(rep + 12)
4. 成立跳转 0x400fc9
5. 恢复空间
6. 程序结束
case6 点击打开
1. eax = 206
2. 跳转 0x400fbe
3. 判断 eax == *(rep + 12)
4. 成立跳转 0x400fc9
5. 恢复空间
6. 程序结束
case7 点击打开
1. eax = 682
2. 跳转 0x400fbe
3. 判断 eax == *(rep + 12)
4. 成立跳转 0x400fc9
5. 恢复空间
6. 程序结束
case8 点击打开
1. eax = 327
2. 跳转 0x400fbe
3. 判断 eax == *(rep + 12)
4. 成立跳转 0x400fc9
5. 恢复空间
6. 程序结束
可见这题答案不止一个,以 case1 为例:
在初始 sscanf 读取输入时
若我们输入 a = 0
switch 语句会跳到 case1 而在 case1 不触发爆炸的条件上文已经提到
b = eax = 207
也就是说其中一组答案是 a = 0, b = 207
其他 7 个 case 同理(已证实),那么恭喜你理解完成了 phase_3 的排雷工作(^O^)
这里你就掌握了循环以及条件判断语句在反汇编里的样子了,既然你掌握了基本的东西,你应该懂的吧(awa),大杂烩要来了
phase_3 这里卡了我 3 个小时,好吧我知道慢了点,但是解出答案还是很爽的对吧!
ps: 16 进制转换我算错了好几次
phase_4
phase_4 点开查看
渐入佳境,我们紧接着来看 phase_4 吧
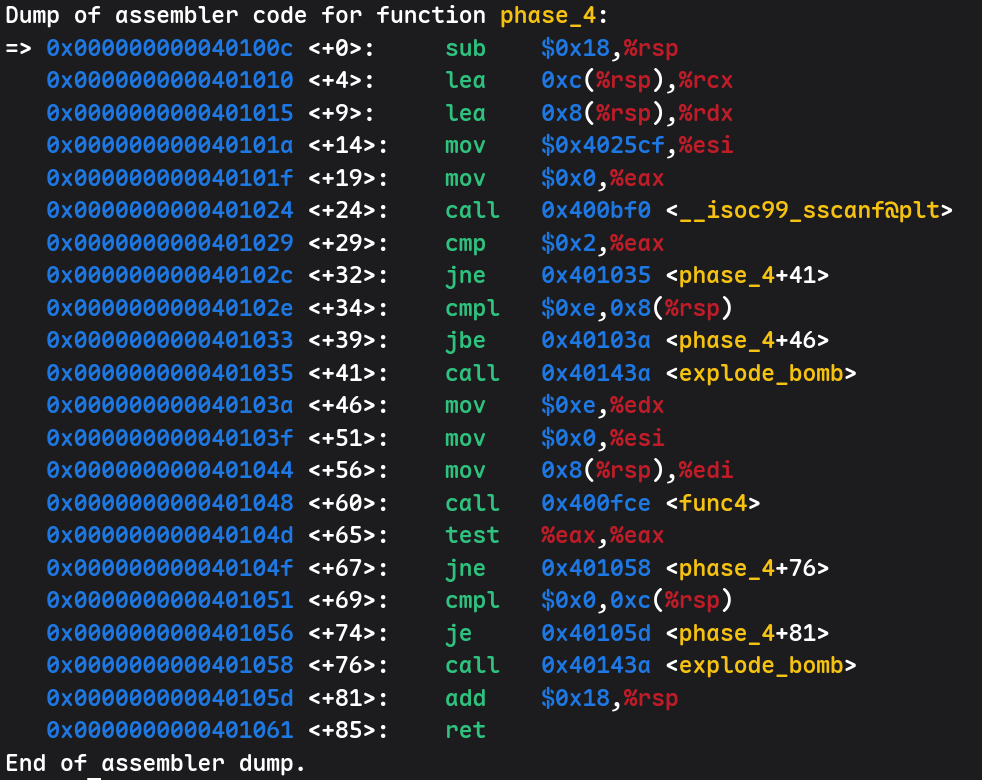
我们不妨约定俗成 a = *(rsp + 8), b = *(rsp + 12)
在正式分析前,我们先认识下几个新的汇编命令
jbe 条件判断(jump if below or equal) 即 <=,无符号数
jle 条件判断(jump if less or equal) 即 <=,有符号数
jge 条件判断(jump if greater or equal) 即 >=
shr 位运算(shift right logic) 逻辑右移(右移时不对符号进行保留)
sar 位运算(shift right Arithmetic) 算术右移(右移时保留数的符号,比如: 最高bit位为 1 在右移后仍然保证为 1 不会自动填充为 0)
ok 咱们正式开始
1. 先申请 24 byte 空间
2. 调用 sscanf 函数, rcx = *(rsp + 12), rdx = *(rsp + 8)
3. 判断 eax != 2 # 这里用来检查 sscanf 的返回值, eax 返回为 2 说明 sscanf 读取了两个变量
4. 未生效
5. 判断 *(rsp + 8) <= 14 # 说明 a <= 14
6. 生效跳转 0x40103a
7. 赋值 edx = 14, esi = 0, edi = *(rsp + 8) # edi = a
8. 调用 func4(esi, edx, edi);
9. 测试 test(eax & eax)
10. 判断 test(eax & eax) 为 jne(jump if not equal)
11. 未生效 # 说明 eax = 0
12. 判断 *(rsp + 12) == 0 # 此处我们可以直接得到 b = 0
13. 生效跳转 0x40105d
14. 恢复空间
15. 程序结束
注意 eax 默认为各个函数返回的
整数值所以,你可以发现在上面很多函数调用指令后紧跟着检测以及检查 eax 的数值
对于 test(%eax, %eax) 段落说明
点击打开查看
我们知道 test 底层实际是按位取与 &
test %a, %b = b & a
而后面紧跟着的条件判断 jne 则是对 test 结果的回应
我们知道每个条件判断以及 test 指令都会修改标志位的数值
点击打开看标志位详情
我们知道条件判断以及 test 命令会修改 cpu 上的标志位,而常见的标志位如下:
| 缩写 | 全称 | 含义 | 什么时候置为 1 |
|---|---|---|---|
| ZF | Zero Flag 零标志 | 运算结果是否为0 | 结果=0 -> ZF = 1,结果!=0 -> ZF = 0 |
| SF | Sing Flag 符号标志 | 有符号数正负 | 结果最高位 bit=1(负数)-> SF = 1, 正数则为 SF = 0 |
| CF | Carry Flag 进位标志 | 无符号数溢出/减法借位 | 最高位进位 -> CF = 1, 减法需要借位时 -> CF = 1 |
| OF | Overflow Flag 溢出标志 | 有符号整数溢出 | 有符号运算超出表示范围则 -> OF = 1 |
| PF | Parity Flag 奇偶标志 | 结果最低8位里1的个数 | 低 8 位中 1 的数量是偶数 -> PF = 1 |
而这里对两个相同数按位取与(&)显然只有两个结果
eax = 0 -> 结果为 0
eax != 0 -> 结果不为 0
这里 jne 会读取 ZF 标志,只有当标志为 0(运算结果为 0)时 jne 才会跳转
此处判断未生效说明 ZF 标志存放结果为 1,即按位与计算结果为 0
这说明 func4 的返回值为 0
但是 func4 在什么情况下才会返回零呢?
依照上面的分析我们已经知道 b = 0,那么对于这题我们只缺 a 的值了,整篇中没有关于 a 的变化指令,除了 a 作为 func4 一个参数这一个线索,所以我们下一步就是了解 func4 究竟是什么
随机我们马上对 func4 进行反汇编
disassemble func4
可以得到如下内容:
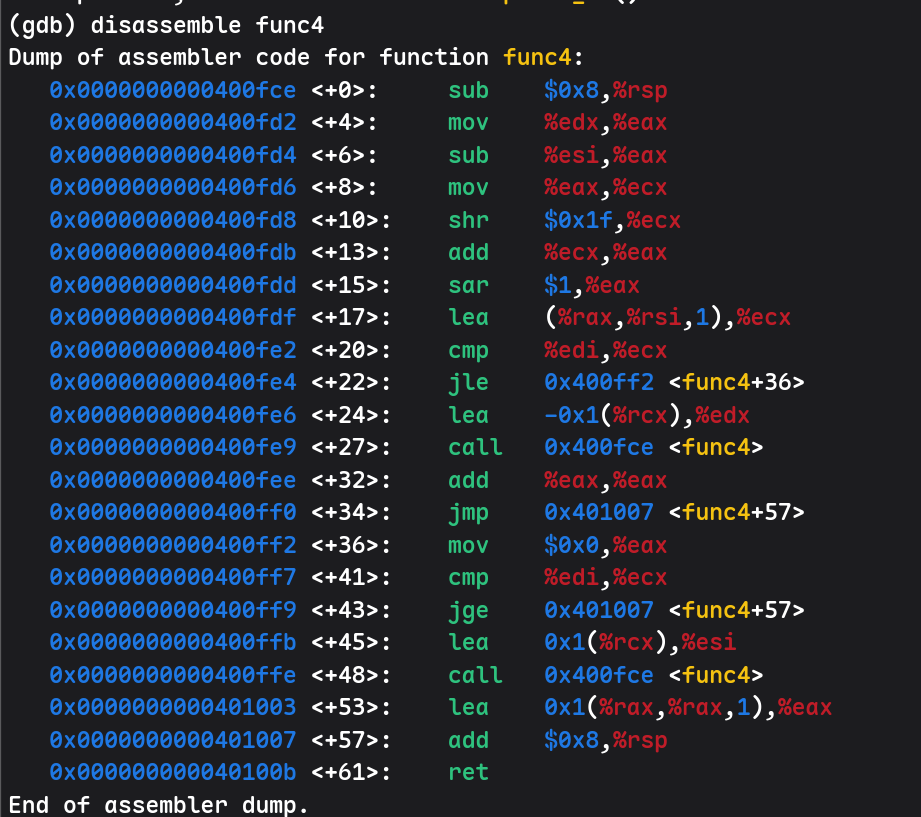
# 函数传入值 (esi = 0, edx = 14, edi = a)
1. 借 8 byte
2. eax = edx
3. eax -= esi # 此时 eax = (edx - esi)
4. ecx = eax
5. ecx 逻辑右移 31 位 # 获得 eax 的数字符号
6. eax += ecx # 此时 eax = (edx - esi) + ecx
7. eax 算术右移 1 位 # 即 eax = eax / 2
8. ecx = rax + rsi * 1 # ecx = eax + esi
第八步的 rax = eax, rsi = esi 的知识涉及寄存器高低位的工作原理,详情可以打开下按键了解
点击打开
部分寄存器是有不同位数适配的,比如
rax(64bit) -> eax(32bit) -> ax(16bit) -> al(8bit)
而低位的寄存器被修改后会自动覆盖高位寄存器
比如 rax = 0x1111111000000000,eax = 0x00114514 -> rax = 0x0000000000114514
对应各个寄存器关系如下表:
| 64 | 32 | 16 | 8 |
|---|---|---|---|
| rax | eax | ax | al |
| rbx | ebx | bx | bl |
| rcx | ecx | cx | cl |
| rdx | edx | dx | dl |
| rsi | esi | si | sil |
| rdi | edi | di | dil |
| rbp | ebp | bp | bpl |
| rsp | esp | sp | spl |
| r8 | r8d | r8w | r8b |
| r9 | r9d | r9w | r9b |
| … | … | … | … |
| r15 | r15d | r15w | r15b |
所以此处
ecx = rax + rsi * 1
其实是高位rax,rsi 继承了 eax,esi 的数值
也就是:
ecx = eax + esi * 1
希望有帮助
现在我们可以发现 ecx = (edx - esi + ecx) / 2 + esi
各位不觉得这个计算方程很熟悉吗?
我们不妨换个展现方式
mid = (high - low + 1) / 2 + low
没错这个就是二分查找的关键部分,我们不妨猜想这个 func4 就是二分查找函数
为了验证我们的猜想我们接着看下面的命令:
9. 判断 ecx <= edi
10.
case1 未生效(ecx > edi)
{
  edx = (rcx - 1) # 让右边界 high = mid - 1
  调用 fun4(esi,edx,edi)
  eax += eax # 理解为返回值 * 2
  函数返回
}
case2 生效(ecx <= edi)
{
  跳转 0x400ff2
  eax = 0
  判断 ecx >= edi
  case 01 生效(ecx >= edi)
  {
      函数返回 # 带着先前已经赋值的 eax = 0 返回
  }
  case 02 未生效(ecx < edi)
  {
      esi = (rcx + 1) # 相当于左边界增加 low = mid + 1
      调 func4(esi, edx, edi)
      eax = (rax + rax * 1) + 1 理解为返回值 * 2 + 1
      函数返回
  }
}
我们可以发现这是个标准的二分查找模板,但是与标准不同的是返回值
可以看到返回值不是 0 / 1 的 bool 值而是 *2 / *2+1 的二进制存储值,可以理解为此处是出题人想让结果记忆每一个子二分查找时的过程
如果是 向下查找则 eax *= 2, 向上查找则 eax = eax * 2 + 1,而刚好找到则 eax = 0
所以可能会出现 eax = (二进制)100110001100 这种情况,其中的 1 / 0 能让我们很直接知晓寻找过程
其中有个很有意思的一点,在 case2 处先对 eax = 0,是为什么?
我们进入 case2 会认为 ecx >= edi,最理想情况是 ecx == edi,所以我们先默认返回结果为 0 为理想情况
ok 我们再回到 phase_4 函数
我们已经分析得出最后 eax = 0 而让 eax = 0 只有一种情况那就是最理想情况 a = (high + low) / 2 我们已经知道调 func4 时的两个边界值 0, 14
自然 a = 7
所以 phase_4 的输入值应该是 7 0
至此,恭喜你已经通过了 phase_4 的考验!
这里我们学习了函数中调用函数的知识,同时也融合了前 3 个 phase 的内容,是不是感觉~~~长脑子了~~~
phase_5
phase_5 点开查看
同样我们先学习下新的指令
1. movzbl (mov + zero-extend + byte-to-long) 从作用变量读取一个字节的数字,零拓展后赋值给因变量
2. xor 按位异或,赋值给因变量
3. and 按位与,与上同理
4. movb (move byte) 将作用变量的一个字节数赋值给因变量
废话不多说直接看反汇编
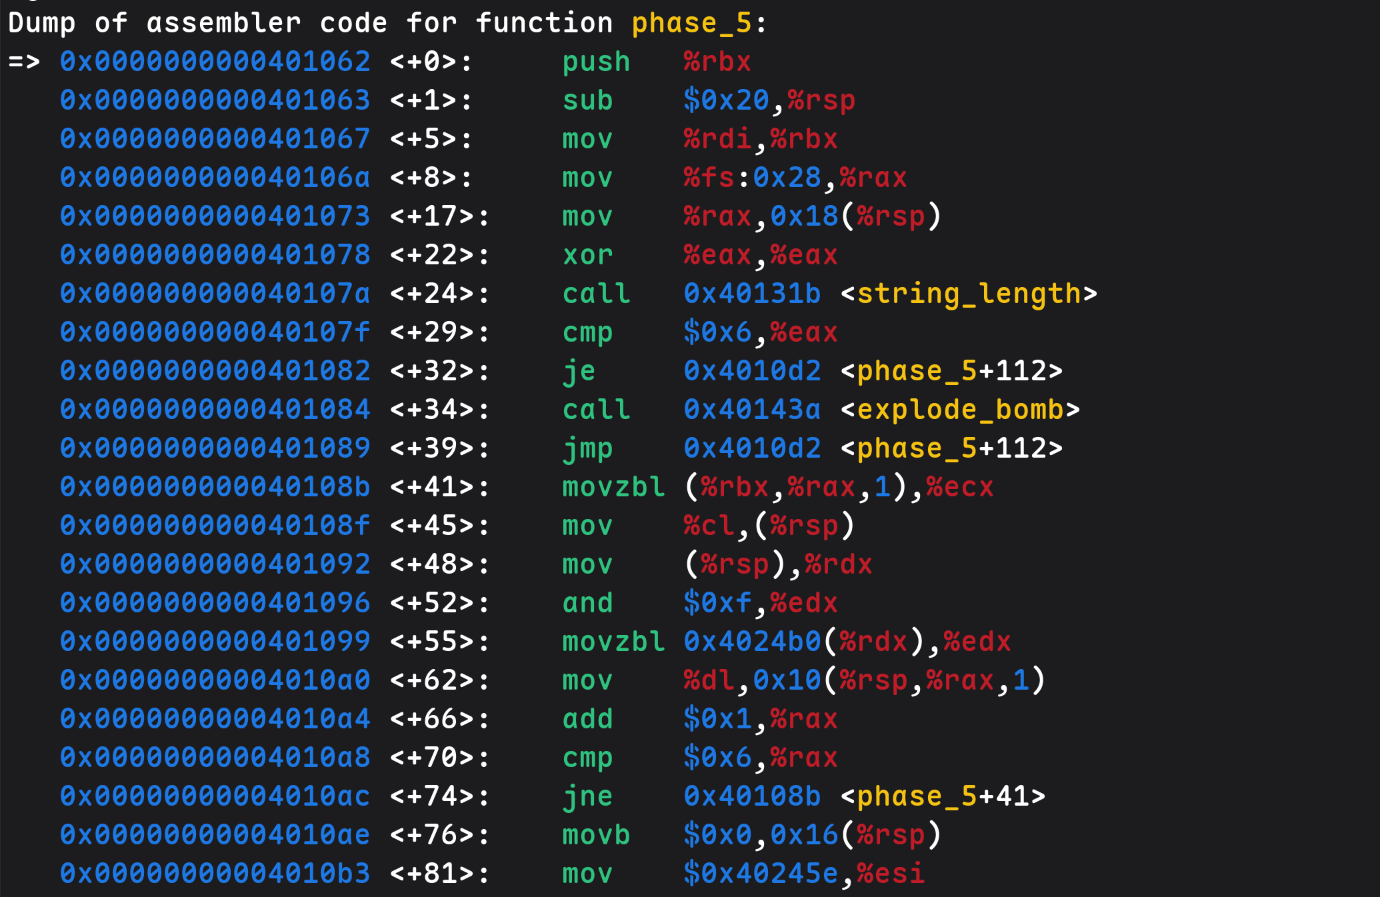
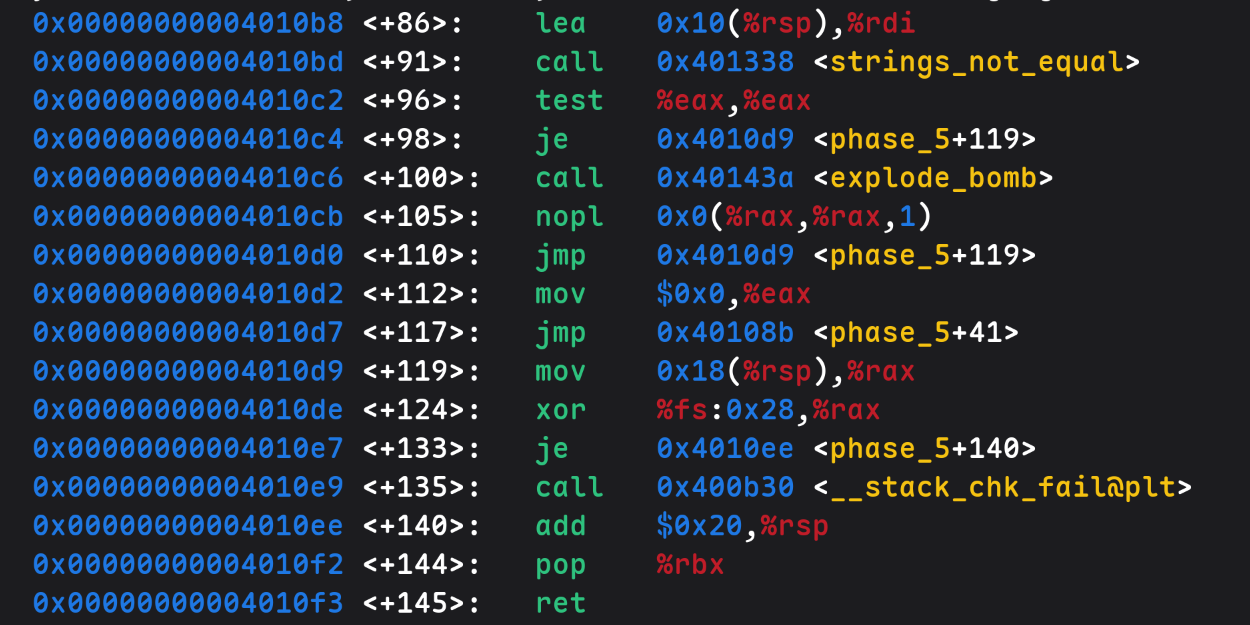
1. 存入 rbx 寄存器,取 32 字节,栈顶指针为 rsp
2. rbx = rdi # 读取调用函数的第一个参数赋值给 rbx(即字符串指针)
3. rax = *(fs + 40)
4. *(rsp + 24) = rax # 3-4步为读取栈保护值(避免栈越界)
5. eax = eax xor eax # eax = 0
6. 调 <string_length>(rbx)
7. 判断 eax == 6
8. 生效跳转 0x4010d2 # 说明输入字符串长度为 6
9. eax = 0 # 注意同时带动 rax 也变为 0
10. 跳转 0x40108b
11. ecx = *(rbx + rax * 1) # 此处 rax = 0 可以理解为读取字符串下指标 0 的字符
12. *rsp = cl # 栈顶放入刚读取的字符 cl 为 ecx 的下 8bit 数据
13. rdx = *rsp # rdx 暂存刚读取字符
14. edx = 0xf & edx # 通过按位与取该字符的前 4bit 信息
15. edx = *(rdx + 0x4024b0) # 在查找表寻找对应字符
16. *[(rsp + rax * 1) + 16] = dl # 在栈 16 地址外存入映射后的字符
17. rax++
18. 判断 rax != 6
case1 生效
{
  跳转到第 11 步 # 可见此处为循环(效果为:对输入字符串重新映射)
}
case2 未生效
{
  见下文分析
}
这里提一嘴 0x4024b0 为查找表在内存的固定地址,仅限于当前这个 bomb lab 实际情况可能并不是这个地址
你可以简单理解为,该 phase 自带了一个映射表对应不同的数字下标会返回不同的字符
为此我们需要知道这个映射表究竟是怎样的,我们才能知道此处对我们输入的字符串做映射会变成什么样子
我们不妨输入:
x/16cb 0x4024b0
表示从 0x4024b0 开始,以 char(c) 形式显示,每项 1 个 byte(b),读取 16 项
读取 16 项是因为之前进行了 edx = 0xf & edx 让 edx 只保留 4bit,也就是 16 位的数据,对应 16 位的映射
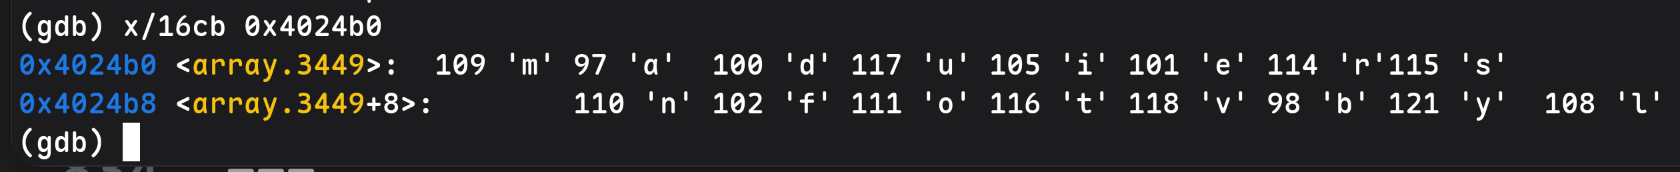
可见映射表的顺序为:
0x0 -> m
0x1 -> a
0x2 -> d
0x3 -> u
0x4 -> i
0x5 -> e
0x6 -> r
0x7 -> s
0x8 -> n
0x9 -> f
0xa -> o
0xb -> t
0xc -> v
0xd -> b
0xe -> y
0xf -> l
ok我们接着看映射完后的内容
续:
case2 未生效
  1. *(rsp + 22) = 0 # rsp 偏移 22 是因为(字符串长度为 6 + 本身的 16 偏移值 = 22),此处是给新字符串设定结束标志符'\0'
  2. esi = *(0x40245e)
  3. rdi = rsp + 16
  4. 调 <string_not_equal>(esi, rdi)
  5. 未生效跳转 0x4010d9
  6. rax = *(rsp + 24) # 取回目前栈保护值位置处的值
  7. rax = *(fs + 40) xor rax # 与真正的栈保护值异或处理
  判断
  case01 结果为 0 # 说明保护值未被覆盖栈未溢出
  {
      1. 跳转 0x4010ee
      2. 程序结束
  }
  case02 结果不为 0 # 异常栈溢出
  {
      1. 调 <_stack_chk_fail@plt>
      2. 程序报错异常
  }
由 case2 里可见 0x40245e 地址处存放着比对的字符串的答案为此我们需要获取这个字符串
x/s 0x40245e
得到:
flyers
而这个是映射后的值,我们需要反映射,根据我们之前得到的映射表,最终我们应输入的答案是:
yonuvw
这里需要对应 ASCII 值可以在 点击此处 查看
根据上面的映射我们只需要看对应的前 4 位值即可,比如 M 对应的 ASCII 值为 0x4d 前 4 位对应 16进制是 0xd 根据上面的对应值是 ‘b’ 其他同理
因此答案不止一个,我们的答案也可以很奇怪比如:
Y/.u6W
但也是对的()
那么恭喜, phase_5 的答案你也得到了!
这里是不是感觉就像~~~黑客一样~~~,让你破解类似凯撒密码的感觉
好了好了,也快到终点了,加把劲我们继续吧!
phase_6
phase_6 点开查看
魔王来了,我们先把反汇编拧上来
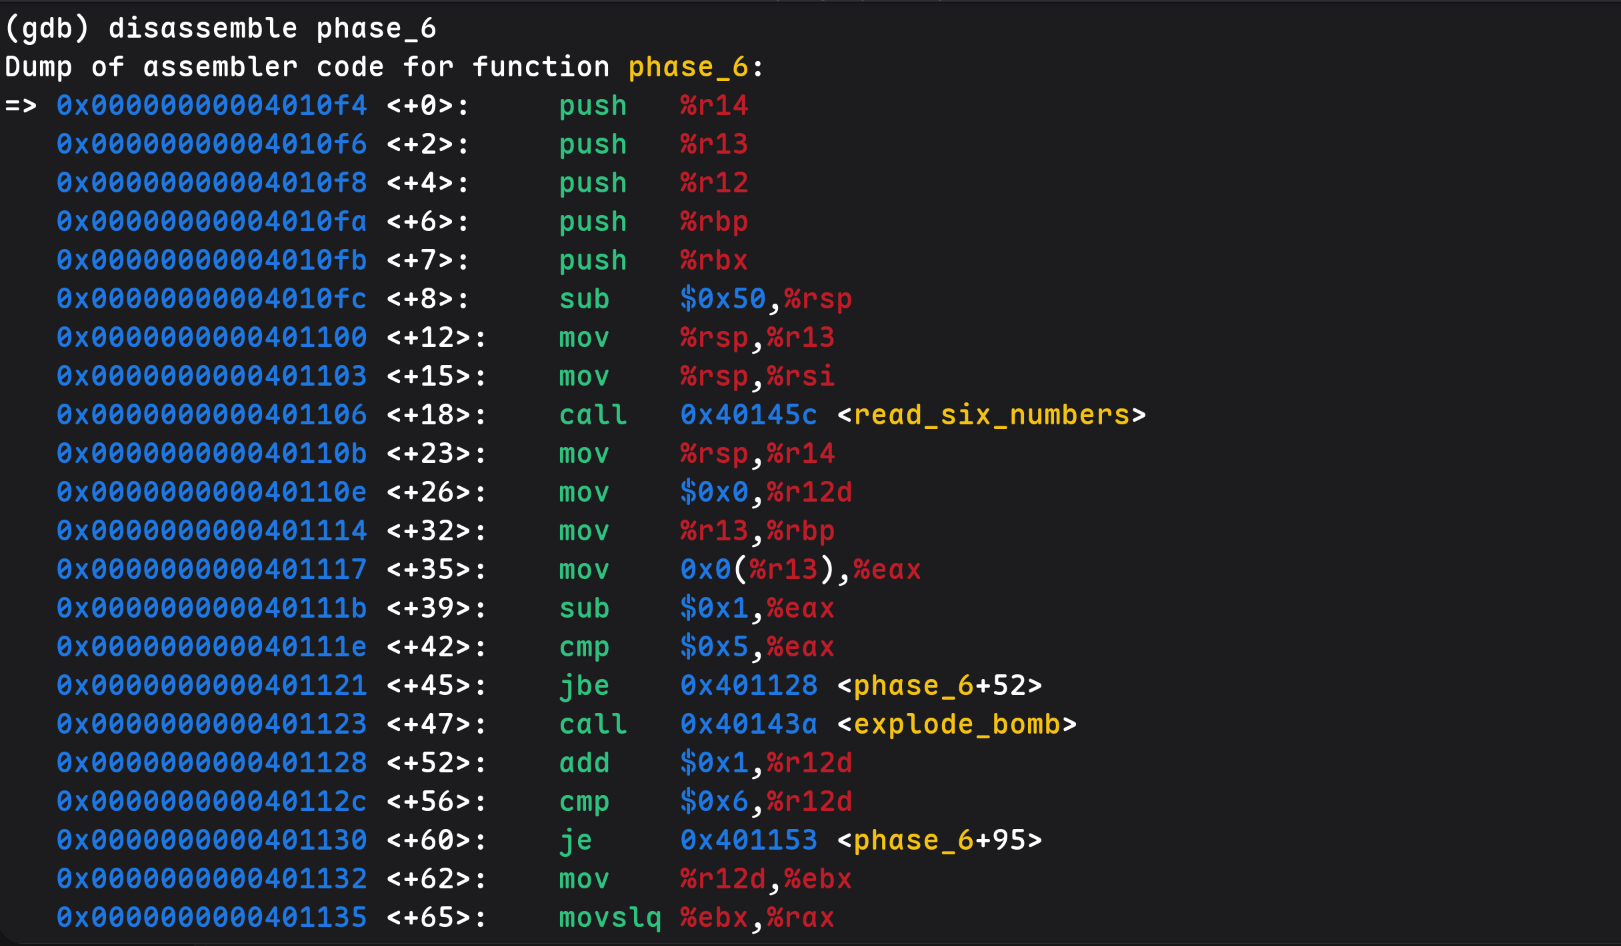
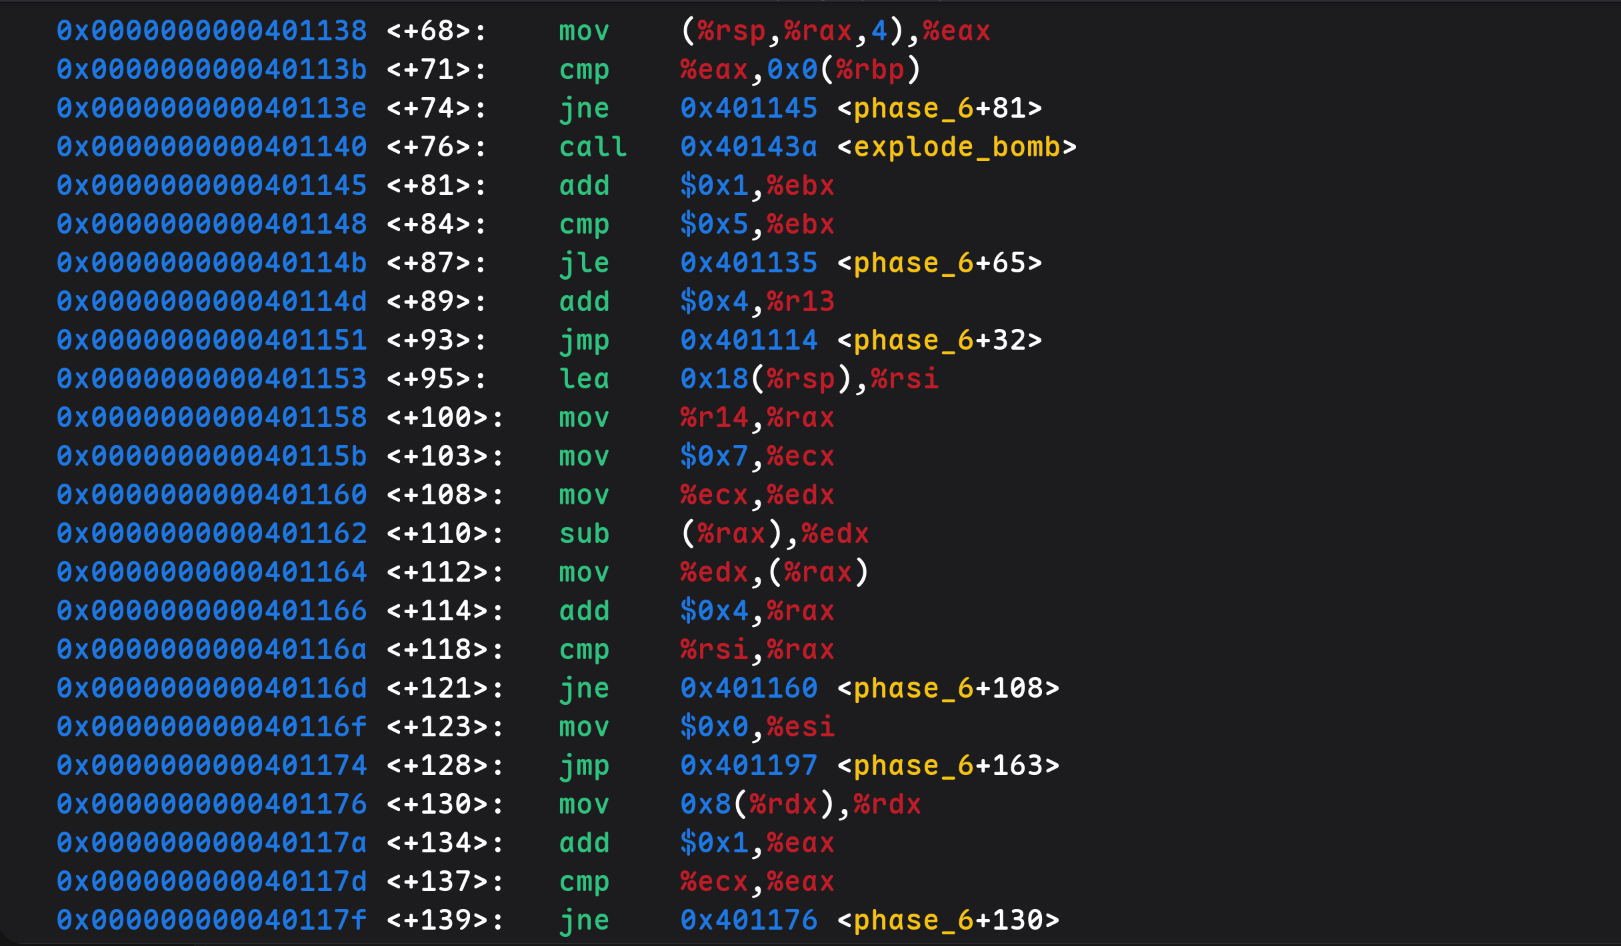
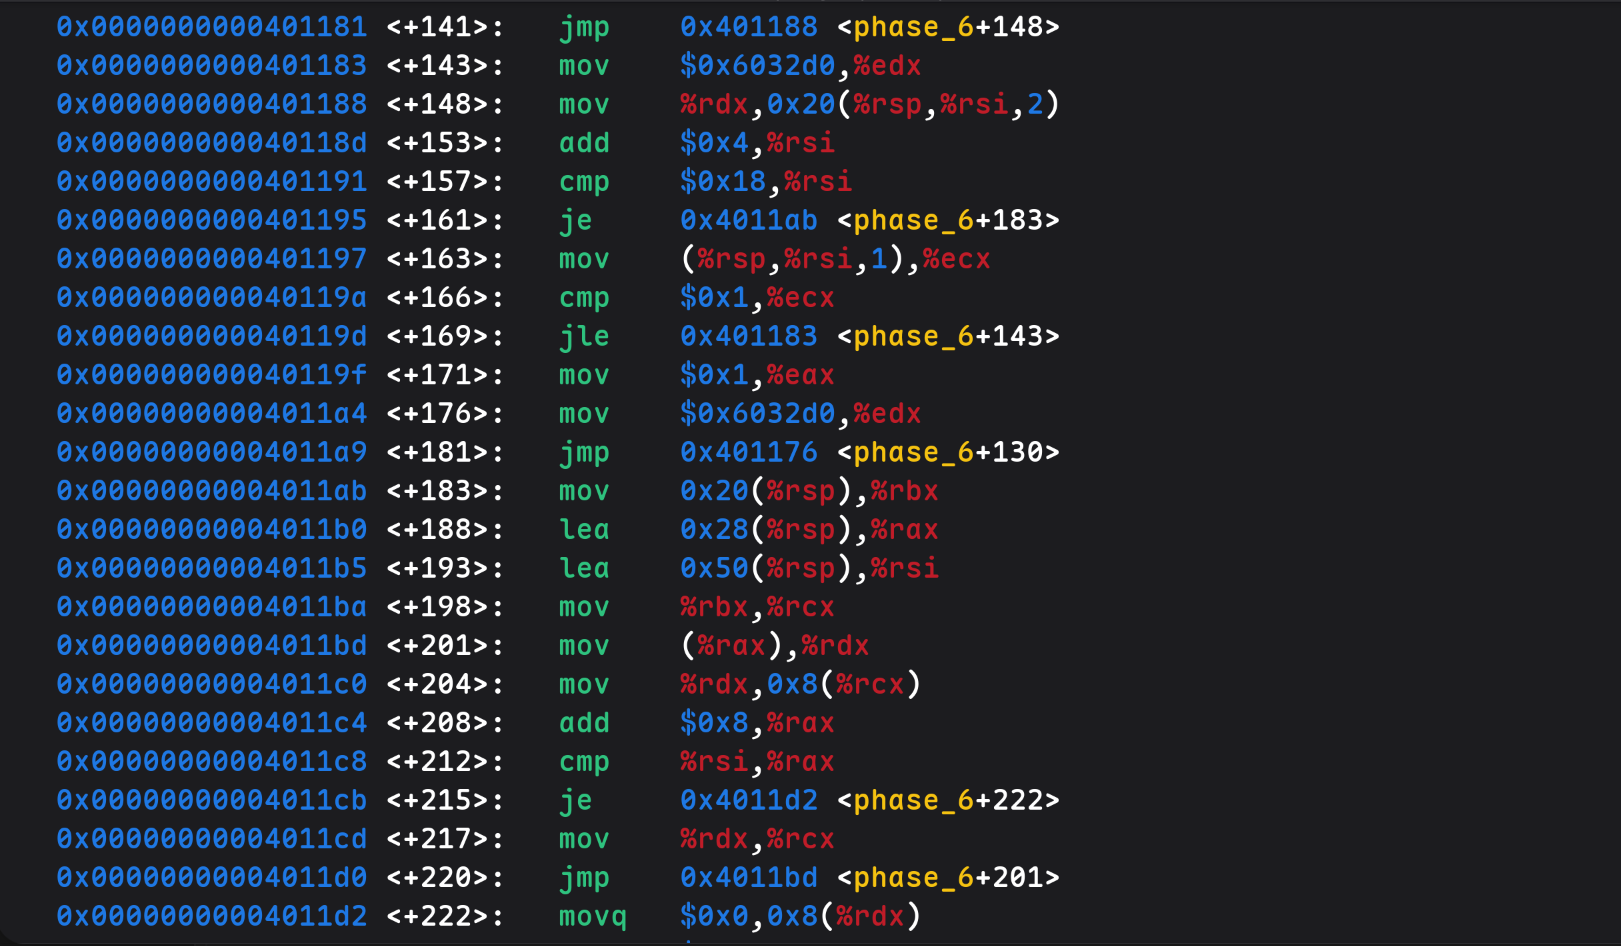
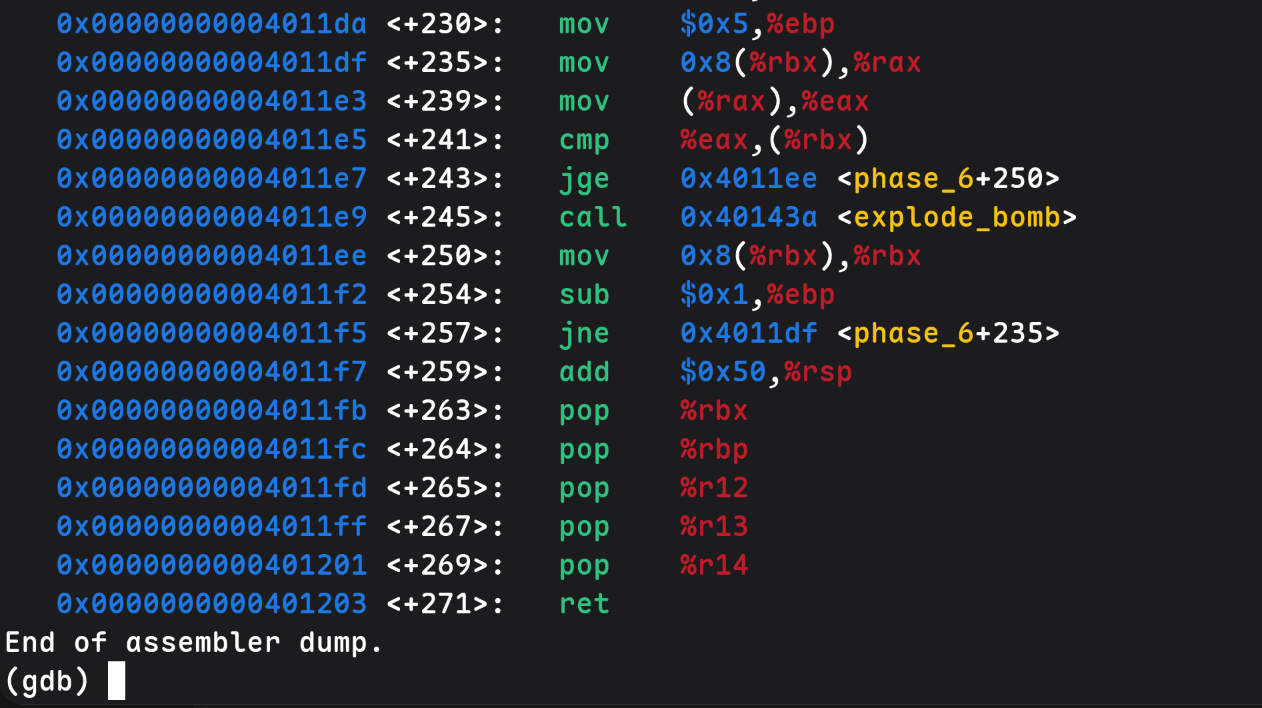
先别被这个数量吓到了,其实我们分块理解并不会太复杂
所以按照惯例我们一个一个来分析
1. 存入 rbx, rbp, r12, r13, r14 寄存器
2. 借 80 byte 空间,栈顶指针 rsp
3. r13 = rsp, rsi = rsp
4. 调 <read_six_numbers> # 可见本题需要输入 6 个数字
5. r14 = rsp # 至此 rsi, r13, r14 都存着数组的头指针
6. r12d = 0 # 作为遍历用的临时下标
7. rbp = r13 # 循环起始点, rbp 指向数组当前的值
8. eax = *(r13 + 0) # eax 获取该值
9. eax -= 1
10. 判断 eax <= 5
11. 生效跳转 0x401128 # 说明数组内输入的值在 1-6 范围内
12. r12d += 1
13. 判断 r12d == 6
case 1 生效
{
    # 进入 case 1 时, r12d = 6
    c1-1. 跳转 0x401153
    c1-2. rsi = rsp +24 # rsi 指向数组的末尾的后一位
    c1-3. rax = r14 # rax 指向数组的头地址
    c1-4. ecx = 7
    c1-5. edx = ecx # 循环起始点
    c1-6. edx -= *(rax) # edx = 7 - 当前下标处的数值
    c1-7. *(rax) = edx # 替换原数组数值
    c1-8. rax += 4 # 遍历下一位
    c1-9. 判断 rax != rsi
    case 01 生效
    {
        跳转 0x401160(即回到 c1-5. )
    }
    case 02 未生效
    {
        # 第二大部分后文接着讲
    }
    # 可见 case1 处的小循环作用是数据处理,将数组内每个数做 (7 - 当前数) 处理,便于后续操作
}
case 2 未生效
{
    c2-1. ebx = r12d # 初次进入时 r12d = 1
    c2-2. rax = ebx # 循环起始点,ebx 作为遍历的临时下标
    c2-3. eax = *(rsp + rax * 4) # eax 获取下标处数值
    c2-4. 判断 *(rbp + 0) != rax
    c2-5. 生效跳转 0x401145
    c2-6. ebx += 1
    c2-7. 判断 ebx <= 5
    case 01 生效
    {
        跳转 0x401135(即回到 c2-2. )
    }
    case 02 未生效
    {
        c2-c02-1. r13 += 4 # 将 r13 下标向后挪一位
        c2-c02-2. 跳转 0x401114(即回到 7. )
    }
} # 至此可以明白 case2 是大循环内的小循环用来确保输入的 6 个数互不相同且数字范围在 1-6 ,若有相同数则爆炸
有一点点复杂对吧?其实这里就是在主循环内套了两个独立的小循环,一来是限制数据范围(1-6,且互不相等),二来是对数据做预处理(7 - 当前数),那么在处理完后就是真正的操作了
所以我们接着看 case1-case02 的内容:
续:
case1
{
    case02
    {
        c1-c02-1. esi = 0 # 同时让 rsi = 0
        c1-c02-2. 跳转 0x401197
        c1-c02-3. ecx = *(rsp + rsi * 1) # 循环起始点
        c1-c02-4. 判断 ecx <= 1
        case 01 生效 # 即原输入数字为 6 的情况
        {
            c1-c02-c01-1. 跳转 0x401183
            c1-c02-c01-2. edx = 0x6032d0 # 作为链表的头节点地址
            c1-c02-c01-3. 同样内容(前往 c1-c02-c02-c02-2. 可见)
        }
        case 02 未生效
        {
            c1-c02-c02-1. eax = 1 # 用来记录存入的节点数
            c1-c02-c02-2. edx = 0x6032d0
            c1-c02-c02-3. 跳转 0x401176
            c1-c02-c02-4. rdx = *(rdx + 8)
            ```
              循环起始点, 8 是一个节点的空间大小,此处类似链表的写法 (cur = cur->next)
            ```
            c1-c02-c02-5. eax += 1
            c1-c02-c02-6. 判断 eax != ecx
            ```
              已知 ecx 是当前遍历的数的数值,而 eax 为计数器,此处要求 cur指针 遍历次数为 ecx 次才结束,可以合理推测 ecx 为输入数的序号(即预处理后的数为序号)
            ```
            case 01 生效
            {
                跳转 0x401176(即回到 c1-c02-c02-4. )
            }
            case 02 未生效
            {
                c1-c02-c02-c02-1. 跳转到 0x401188
                c1-c02-c02-c02-2. *[(rsp + rsi * 2) + 32] = rdx
                ```
                  此处为偏移值将 edx 的值放在 (rsp + 32 + 下标 * 2) 的位置上,对于输入 6 的特殊情况则是将该 6 的节点作为头节点存入
                ```
                c1-c02-c02-c02-3. rsi += 4 # 下标后移
                c1-c02-c02-c02-4. 判断 rsi == 24
                case 01 生效
                {
                    # 第三大部分后面接着讲
                }
                case 02 未生效
                {
                    同样内容(前往 c1-c02-3. 可见)
                }
            }
        }
    }
}
可见 case1-case02 部分主要是对处理后的数据用链表重新进行排序
比如:
原输入数据: 3 6 1 4 5 2
处理后数据: 4 1 6 3 2 5
那么 case1-case02 会创建链表以 4 1 6 3 2 5 作为序号存入他们在链表上的地址
栈上: (&节点4) (&节点1) (&节点6) (&节点3) (&节点2) (&节点5)
数组:   [1]      [2]      [3]      [4]      [5]      [6]
至于存入后要做什么我们就要看第三个大部分(c1-c02-c02-c02-c01)了
由于 c1-c02-c02-c02-c01 前缀过于长 这里用 ../ 代替
case ../
{
    ../1. 跳转 0x4011ab
    ../2. rbx = *(rsp + 32) # 这里 rbx 为链表的头结点
    ../3. rax = rsp + 40 # 头结点的 next 地址
    ../4. rsi = rsp + 80 # 链表尾数据地址
    ../5. rcx = rbx # 存储头结点到 rcx
    ../6. rdx = *(rax) # 循环起始点, rdx 为当前遍历的节点
    ../7. *(rcx + 8) = rdx # 让头结点指向当前遍历的节点
    ../8. rax += 8
    ../9. 判断rax == rsi
    case 01 生效
    {
        ../c01-1. 跳转 0x4011d2
        ../c01-2. *(rdx + 8) = 0 # 设置末节点的 next 为 0 即 NULL
        ../c01-3. ebp = 5
        ../c01-4. rax = *(rbx + 8) # 循环起始点
        ../c01-5. eax = *(rax)
        ../c01-6. 判断 *(rbx) >= eax
        ../c01-7. 生效跳转 0x4011ee
        ../c01-8. rbx = *(rbx + 8)
        ../c01-9. ebp -= 1
        ../c01-10. 判断 ebp != 0
        case 01 生效
        {
            ```
              这段是确保链表里存的值是一个单调不增的结构(如: 7 6 5 5 3 1),若出现前一个数小于后一个数则爆炸
              而它的检查顺序是按照我们之前在栈上输入的序号顺序而组成的链表进行检查
            ```
            跳转 0x4011df(即回到 ../c01-4.)
        }
        case 02 未生效
        {
            ../c01-c02.1 恢复栈空间
            ../c01-c02.2 程序结束
        }
    }
    case 02 未生效
    {
        ```
          这里各位可以自己试着画下图来稿清楚各个指针的作用,大体上是把链表串起来,之前只是各个节点地址被存在栈上,但是链表本身并没有串起来,这里就是这个功用
        ```
        ../c02-1. rcx = rdx
        ../c02-2. 跳转 0x4011bd(即回到 ../6.)
    }
}
至此我们终于明白了,我们输入的 6 个数其实是序号,经过处理后这 6 个互不相等的数就是链表的排序,而我们要做的就是通过这个输入排序让最后的链表单调不增
but…我们有个新的问题,链表上的 6 个数据在哪呢?我们并没有得到
聪明的你肯定想到了,没错自己去编译查看!
x/wd 0x6032d0 # 0x6032d0 为链表头的地址
x/gx 0x6032d8 # (头指针地址 + 8) 看 next 指向的下一个地址
d -> 用有符号10进制显示, x -> 用16进制显示, g(giant word) -> 8字节大小, w(word) -> 4字节大小
依次我们一直遍历,直到 next = 0 才停止遍历,随后我们可以得到如下数字:
0x6032d0 332
0x6032e0 168
0x6032f0 924
0x603300 691
0x603310 477
0x603320 443
0x0
为了单调不增我们需要对这 6 个数做如下排序:
332 168 924 691 477 443
[1] [2] [3] [4] [5] [6]

3 4 5 6 1 2 # 这个为我们选择的顺序
逆向预处理之后原输入数据为:
4 3 2 1 6 5
这个便是我们要输入的答案,怎么样?分块理解也没这么难~~~~对吧~~~~
那么恭喜你,至此完成了 Bomb-lab 的 6 个所有的 phase 但是….?你是不是忘了什么……没错,还有个隐藏 phase 呢,详情在彩蛋内容处查看
彩蛋
当你按下 Control + C(即停止程序) 后,你会发现有如下彩蛋,还是很有意思哈

secret_phase
咳咳好了好了,来讲正事关于隐藏的 phase 思路如下:
secret_phase
想要找到 secret_phase 我们需要先了解 phase_defused 函数是怎么运作的,从 C 的源码知道每个题都有调用 phase_defused 函数,那么这个函数肯定藏着隐藏 phase 的信息
我们不妨对 phase_defused 进行反汇编
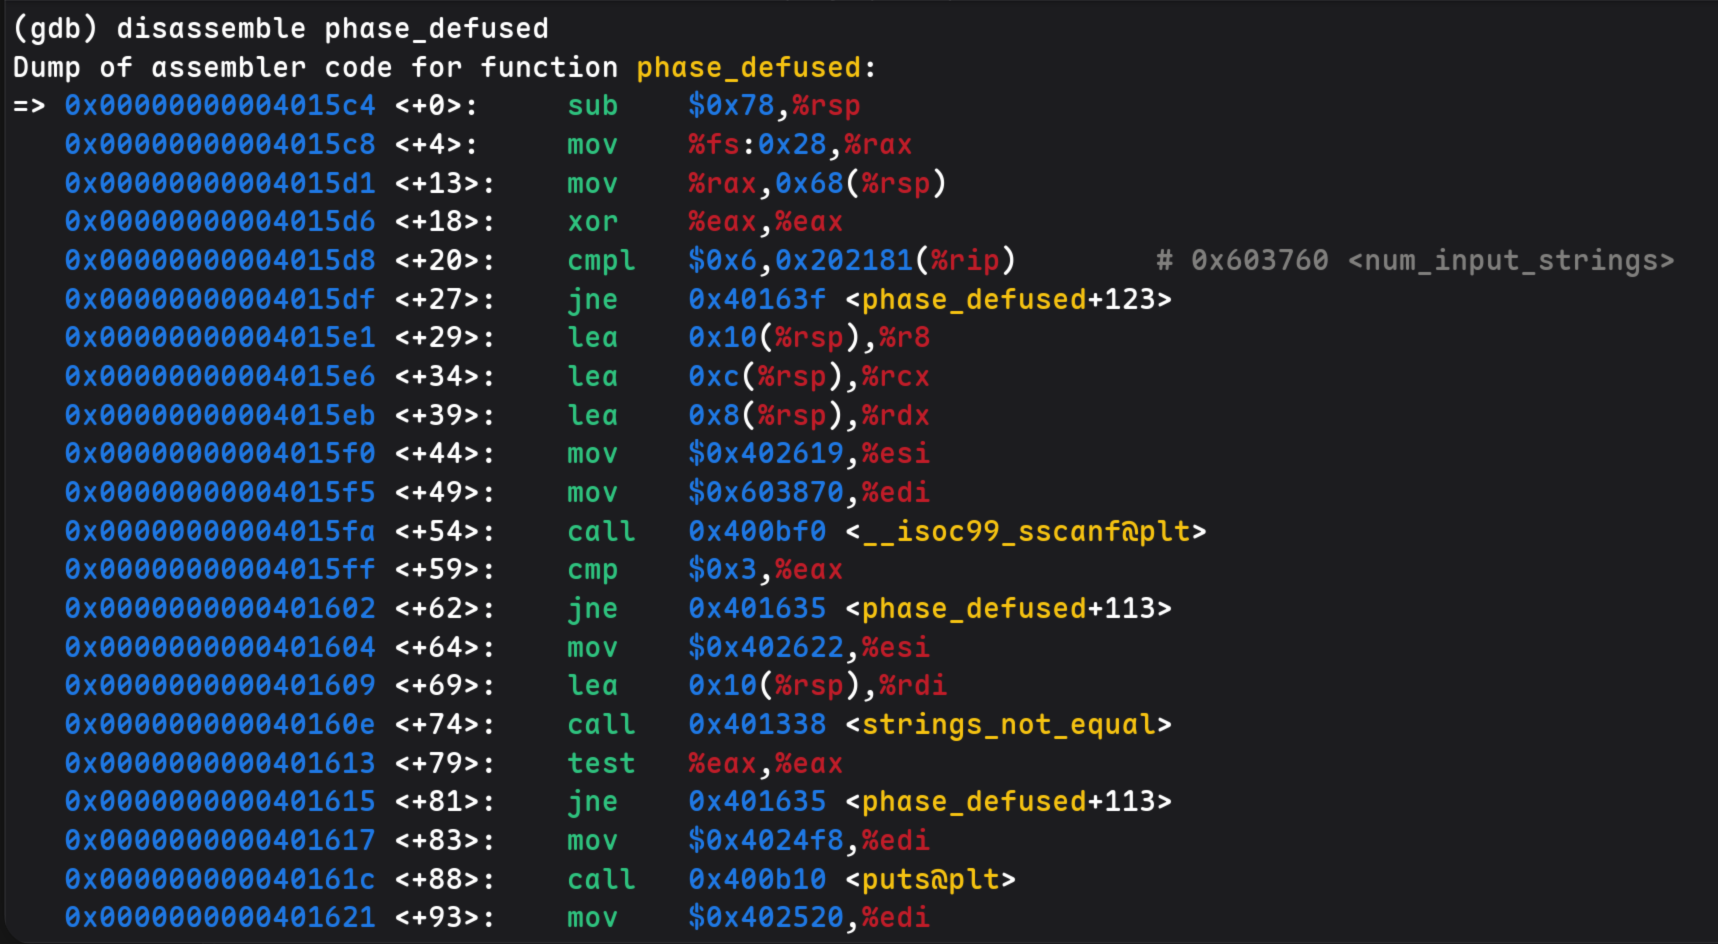
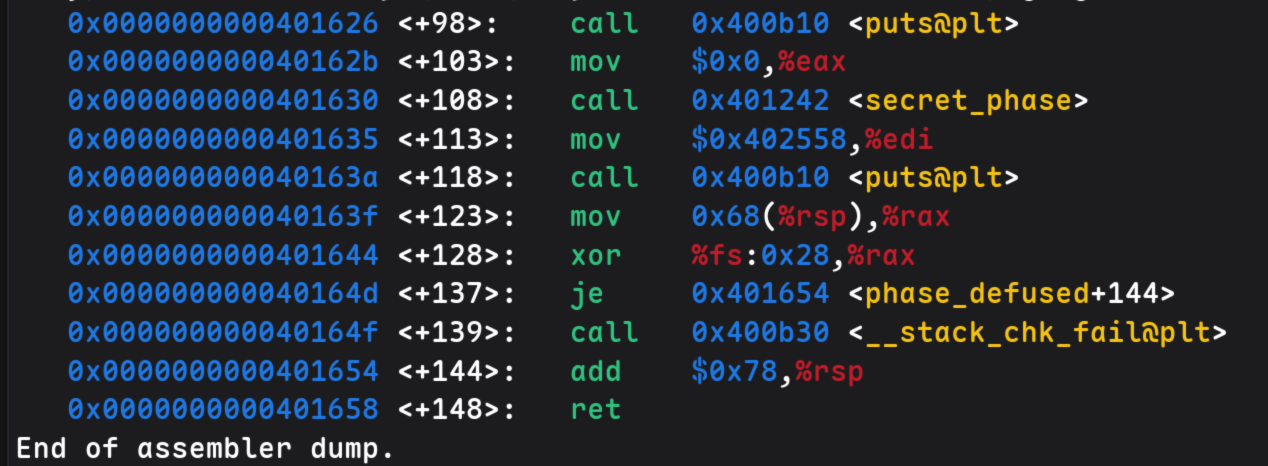
我们可以发现如果想要成功调用:
<secret_phase>
我们必须避免前面的三个 jmp 成功触发,分别是这3个:
1. num_input_strings != 6, 不能成立
2. sscanf 读取目数 != 3, 不能成立
3. strings_not_equal 返回非 0, 不能成立
也就是说进入 secret_phase 我们要2个条件:
1. 6 个 phase 都正常通过
2. 在 phase_4 调用 sscanf 的时候除了答案的两个数,还需要写入一个字符串成功让 strings_not_equal 返回 0(即相等)
至于为什么是 phase_4 理由如下:
sscanf 读取的时候读取地址是 0x603870
意味着判断的输入行是 0x603870 处的输入

我们可以输入 info address input_strings 会返回:
  Symbol "input_strings" is at 0x603780 in a file compiled.

这说明输入槽从 0x603780 开始,那么到 0x603870 是哪个 phase 呢?

0x603870 - 0x603780 = 0xf0 = 240

但是每个 phase 的输入间隔是多少呢?

为此我们需要反汇编 read_line 函数才能知道
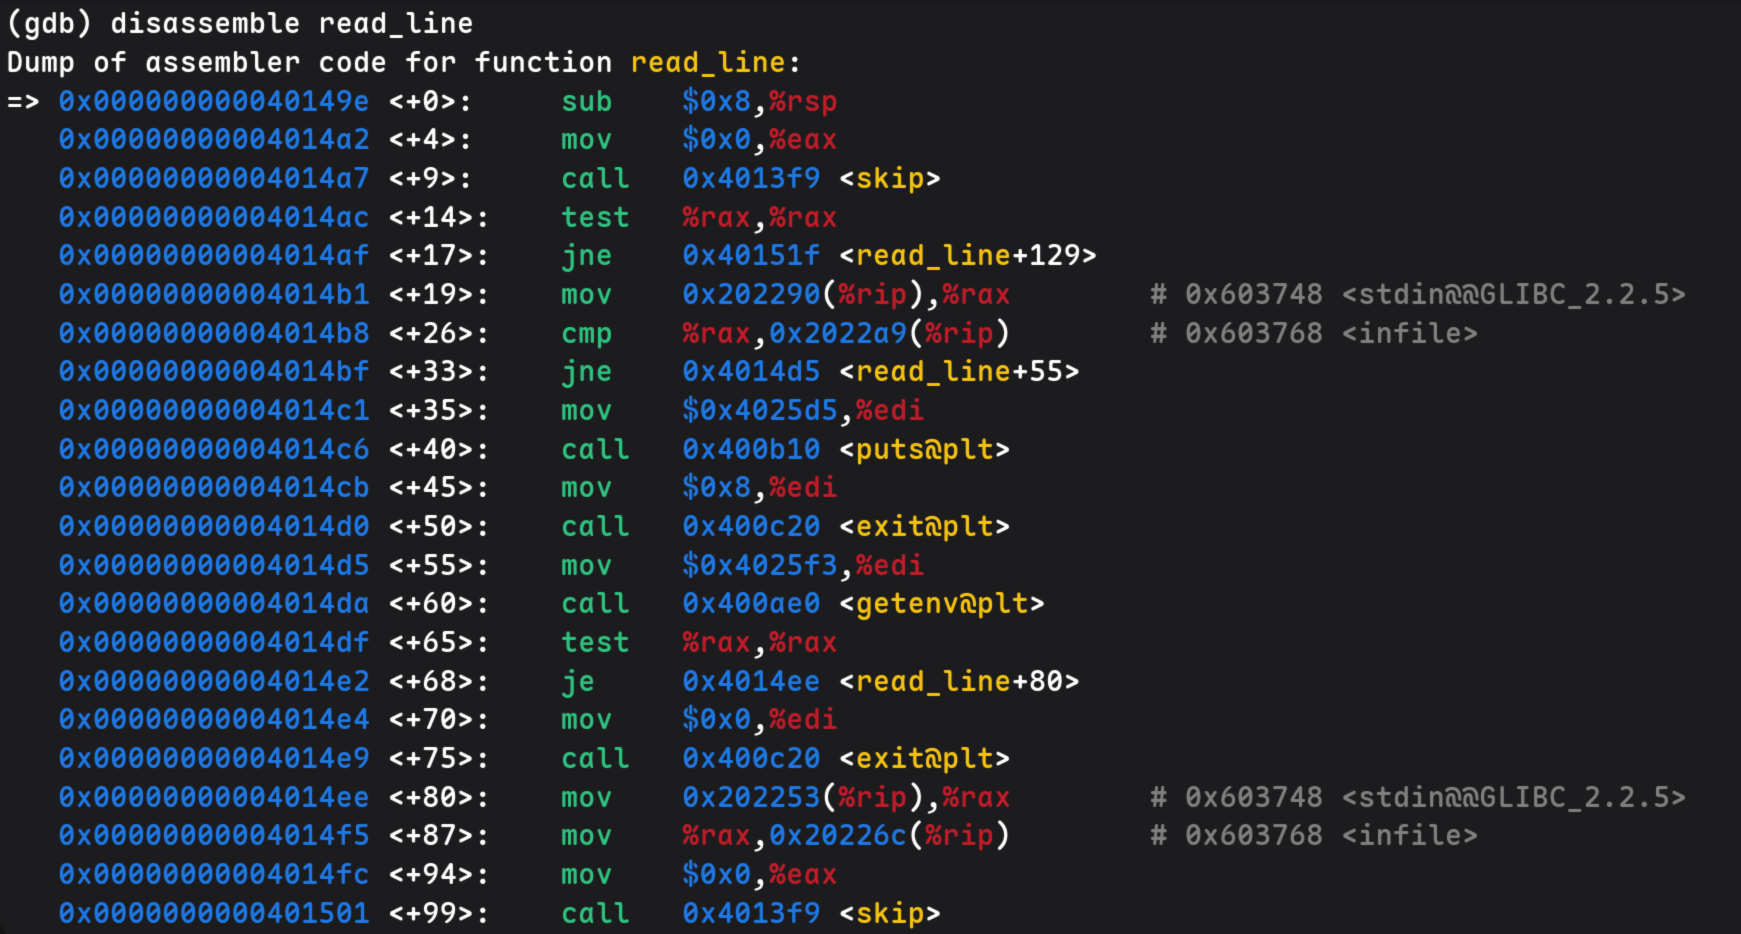
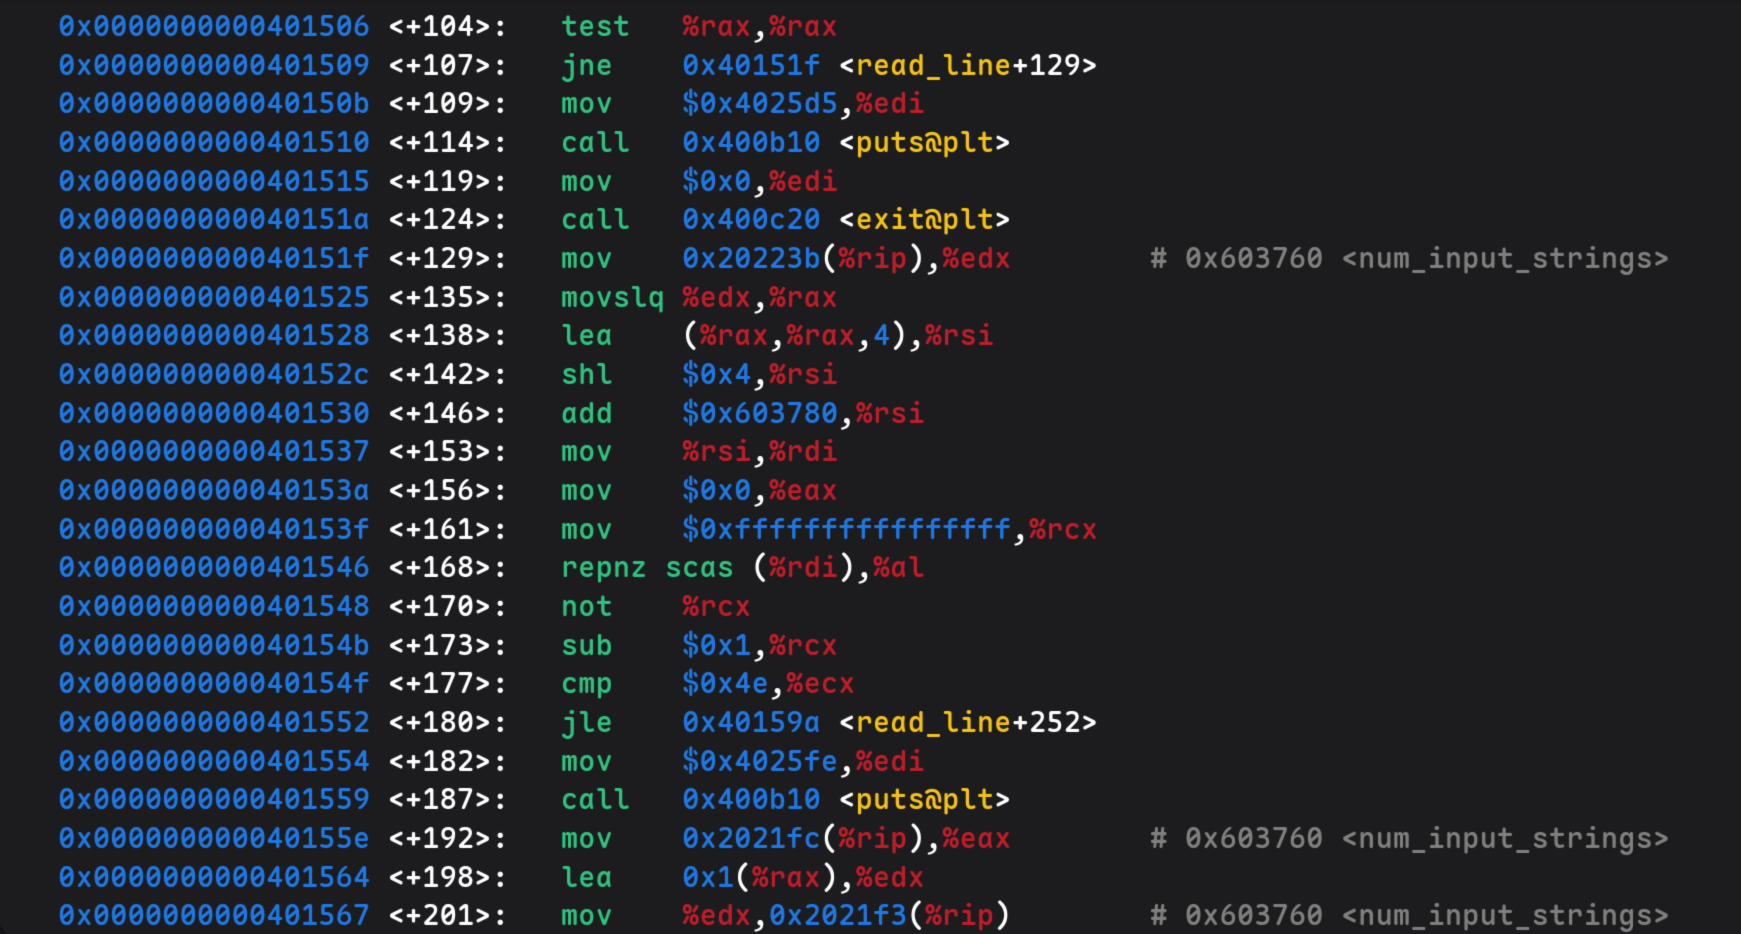
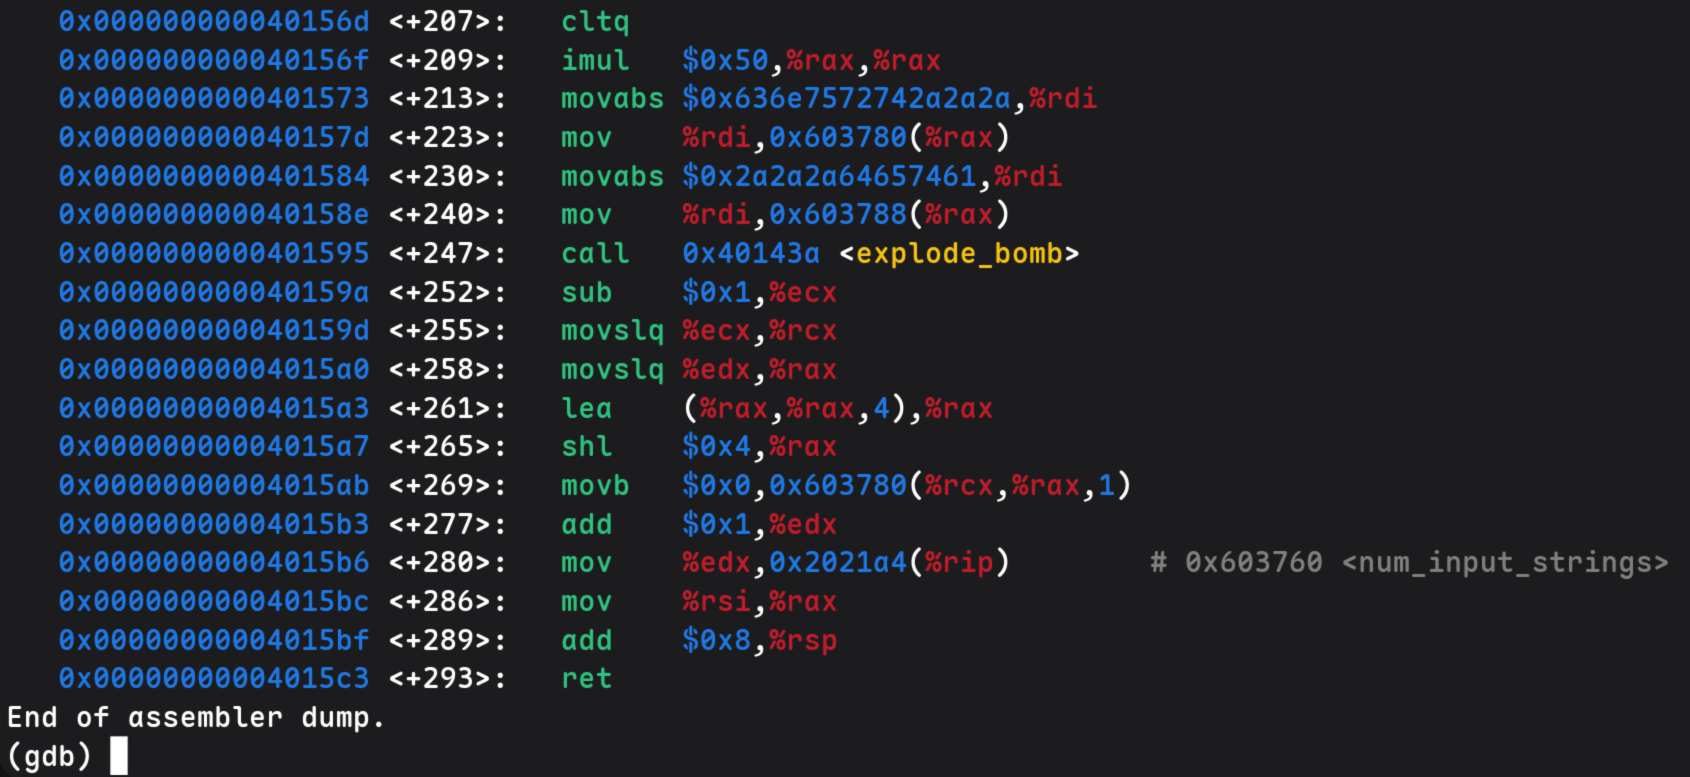
其中我们可以看到这行:
   0x000000000040151f <+129>:	mov    0x20223b(%rip),%edx        # 0x603760 <num_input_strings>
   0x0000000000401525 <+135>:	movslq %edx,%rax
   0x0000000000401528 <+138>:	lea    (%rax,%rax,4),%rsi
   0x000000000040152c <+142>:	shl    $0x4,%rsi
   0x0000000000401530 <+146>:	add    $0x603780,%rsi
   0x0000000000401537 <+153>:	mov    %rsi,%rdi
也就是说 rsi = (rax + 4 * rax) * 2^4 + 0x603780 = 80 * rax + 0x603780
每个 phase 的读取间隔是 80byte 那么 240 / 80 = 3 按照下标自然就是 phase_4 咯
那么我们在 phase_4 需要输入的字符串是什么呢?
还记得我们 phase_1 学到的技巧吧
x/s 0x402622
可以得到:
DrEvil
原来是博士的大名啊
那还等什么,我们只需要将 phase_4 的答案后加一个 DrEvil 就可以了
这样我们就成功进入 secret_phase 了
进入之后就要….?没错,反编译之后就是我们正常的解密环节了!
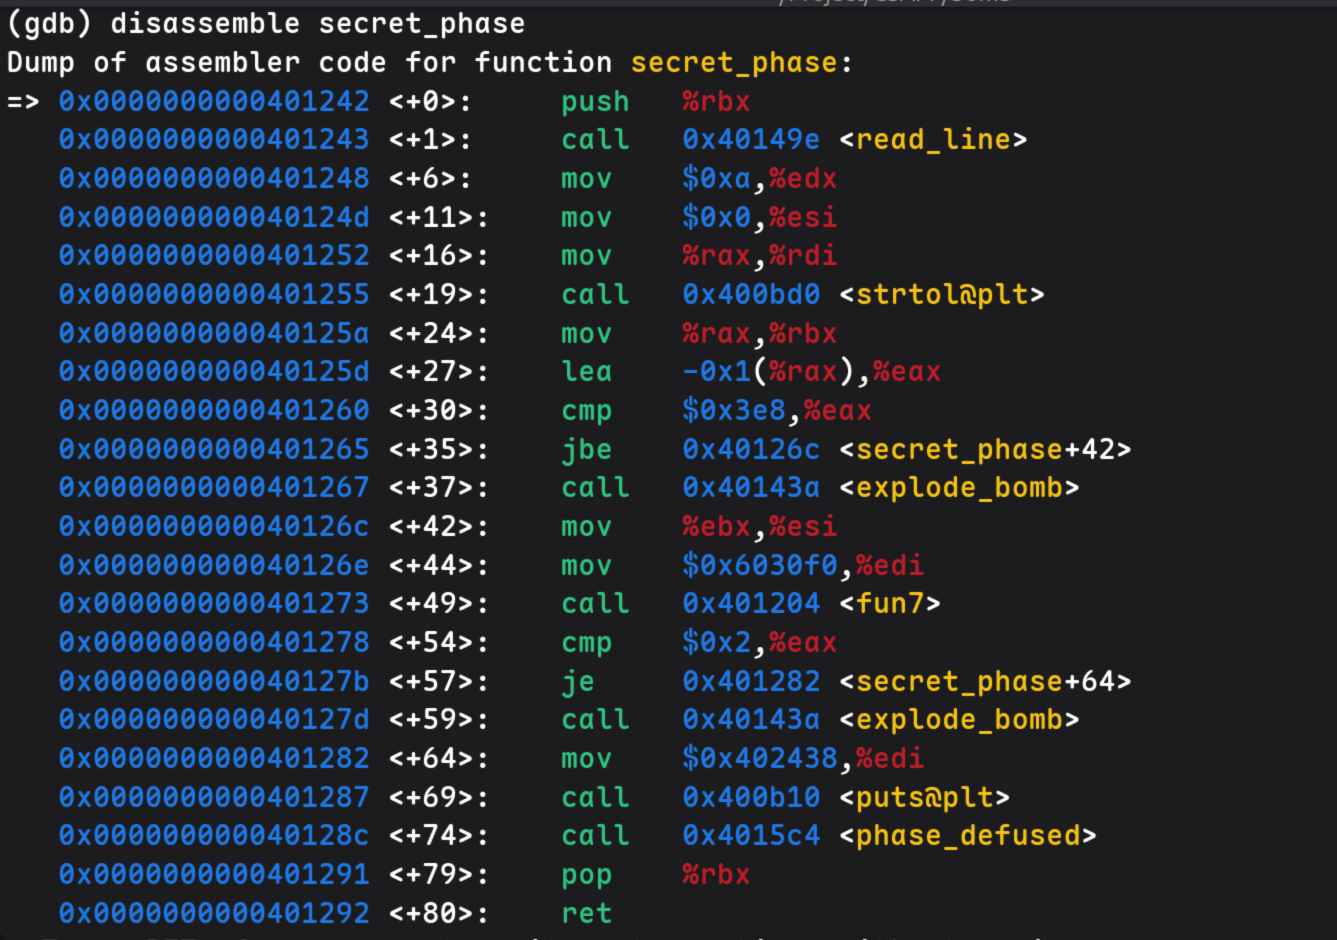
由于帖主实在是写不动了这里只讲个大概
这里是个考验 递归+二叉树 知识的题目
本题通过 func7 递归查找数,每往深的一层探索:
    1.左移 -> 子调用返回值 * 2
    2.右移 -> 子调用返回值 * 2 + 1
    3.发现寻找的数时返回 0

而本题要求 func7 最终返回值为 2
我们先根据指针逐个读取节点的数值,再根据左右孩子,可以复刻出整个树的结构:
                         36
                  /             \
                 8               50
              /     \          /     \
             6       22       45      107
            / \     /  \     / \      /  \
           1   7   20  35   40  47   99  1001
按照上述规则若是返回值为 2 只有两种情况:
1. 左->右->左(20)
2. 左->右(22)
因此该题的答案有两个 20/22
那么恭喜你,成功的完成了 Bomb-lab 的所有题目,肯定耗了你不少的脑细胞吧(^~^)
在此记录贴主花费时间 20d(并非实际时间)
书写不易,如果文章有什么错字或者错误,欢迎指正,你可以在 b站 联系到我 点击跳转
留言
GitHub ↗使用 GitHub 登录留言